
Підрядник відремонтував насос і надіслав рахунок та акт. Інженер підтвердив готовність обладнання, але дані про деталі, роботи й вартість ще треба перенести до реєстру. На цьому умовному прикладі розберемо, коли ШІ допоможе з обробкою документів, які поля перевіряти вручну та як виміряти результат. Фінансовий запис і дозвіл на експлуатацію при цьому залишаються різними рішеннями.
Операційний розрив у даних про ремонти
У нашому ілюстративному сценарії ремонту насоса фізична робота завершується, коли інженери успішно тестують обладнання. Однак інженерне приймання не означає автоматичного оновлення корпоративного реєстру активів. Фінансові документи, записи про технічне обслуговування та статус готовності є окремими сутностями. Доки діловоди вручну не опрацюють вхідний рахунок за ремонт та акт приймання-передачі, планувальники бачать повністю функціональний актив як недоступний.
Ця адміністративна затримка безпосередньо перешкоджає реалізації принципу циркулярної економіки, який полягає в утриманні продуктів і матеріалів в обігу з їхньою максимальною корисністю. Коли статус обладнання залишається невідомим через затримку документів, компанія може ініціювати непотрібні закупівлі або оренду для покриття уявного дефіциту. Рішення про автоматизацію вилучення даних з цих документів спрямоване на усунення цього розриву.
Захоплення даних одразу після отримання документа підтримує перевірку того, чи цифровий запис відображає фізичний стан обладнання. Замість ручного введення налаштовується конфігурований процес вилучення, де система ідентифікує ключові параметри ремонту та передає їх до відповідних реєстрів. Проте швидкість обробки слід збалансувати з необхідністю перевірки якості розпізнавання, щоб уникнути помилок у базі.
Джерела: [1]
Налаштування робочого процесу вилучення
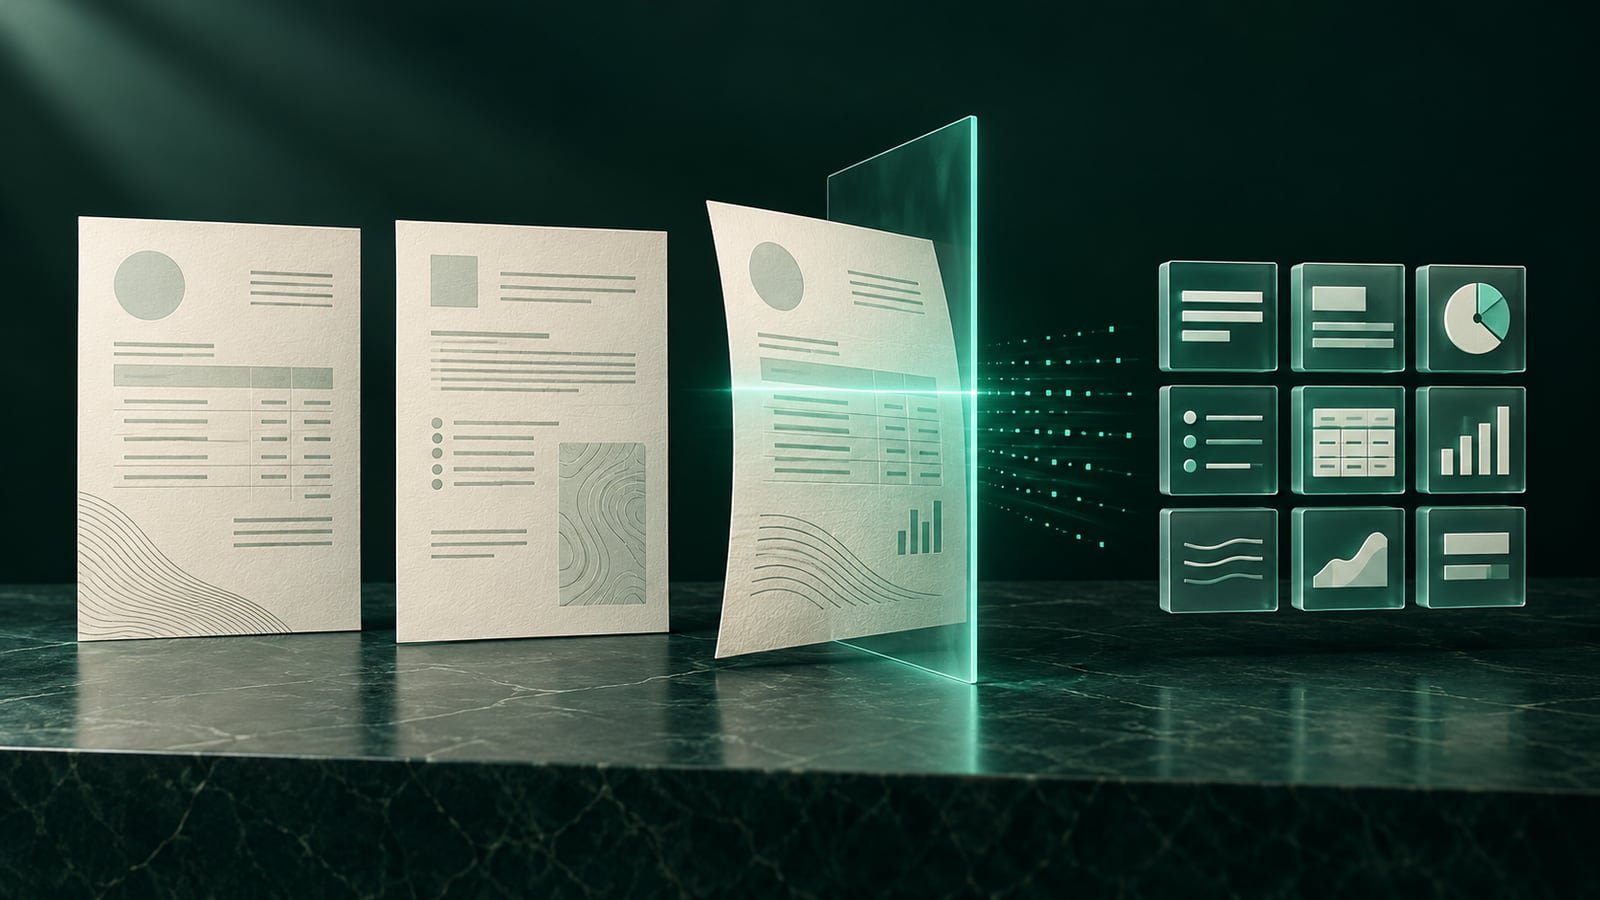
Автоматизація цього процесу вимагає налаштованого робочого процесу, а не простого встановлення готового продукту. Коли підрядник надсилає рахунок за ремонт електронною поштою, система захоплює файл. Далі моделі оптичного розпізнавання символів (OCR) та штучного інтелекту намагаються вилучити конкретні поля: дату обслуговування, вартість робіт та перелік замінених деталей.
Організації можуть використовувати Scriptum.DMS як систему управління документами з можливостями ШІ-обробки та класифікації для забезпечення контексту цього робочого процесу. Проте операційна команда повинна чітко перевірити можливості моделі OCR, правила зіставлення ідентифікаторів та підтримку API для цільової ERP-системи. Налаштований робочий процес повинен вміти відображати довільний текст постачальника на стандартизований внутрішній ідентифікатор обладнання.
Критично важливо, щоб система не намагалася вгадати відсутні дані. Якщо серійний номер невідомий або нечитабельний, штучний інтелект не повинен його вигадувати; він зобов'язаний позначити ці дані як відсутні. Будь-яка спроба алгоритму згенерувати ідентифікатор руйнує цілісність історії технічного обслуговування.
Джерела: [2]
Обробка невизначеності ШІ та винятків
Моделі штучного інтелекту можуть з високою впевненістю видавати помилковий результат, генеруючи високі оцінки точності для неправильних даних. Тому процес вилучення повинен включати детерміновані перевірки ідентифікаторів та посилань за відомою базою даних. Якщо ідентифікатор постачальника або серійний номер не проходить цю детерміновану перевірку, система повинна направити документ у чергу винятків для обробки людиною.
Управління ризиками, пов'язаними зі штучним інтелектом, вимагає структурованого людського контролю для неоднозначних випадків або ситуацій з високим впливом. Коли оператор розглядає виняток, інтерфейс може використовувати розділений екран для порівняння оригінального файлу з вилученими даними, хоча це лише один із варіантів інтерфейсу. Критичним показником тут є фактичний час, витрачений на виправлення помилки.
Автоматизований робочий процес потребує налаштування перевірки на наявність дублікатів, ідемпотентності повторних спроб та контролю доступу до конфіденційних даних. Аудиторський слід підтримує перевірку транзакцій, фіксуючи, хто саме авторизував остаточне розміщення даних у реєстрі. Компроміс полягає у виборі між глибиною логування та продуктивністю системи під час масового завантаження документів.
Джерела: [3]
Оцінка точності порівняно з надійністю
Оцінка системи вимагає чіткого розмежування між точністю вилучення та надійністю процесу. Точність на рівні полів означає точний збіг вилученого поля з еталонними даними, а не просто схожість на рівні символів. Коректність документа вимагає, щоб усі обов'язкові поля в одному документі були правильними відповідно до фактичних даних.
Ці показники відрізняються від наскрізної автоматичної обробки (straight-through processing), яка просто вимірює відсоток документів, що проходять без втручання людини, навіть якщо вони містять невиявлені помилки. Натомість надійність наскрізного процесу визначається як коректне, авторизоване розміщення даних у цільовому реєстрі без втрат або дублікатів.
Зниження порогу впевненості ШІ для збільшення відсотка автоматичної обробки не є автоматичним рішенням для зменшення витрат; це створює неконтрольовані ризики помилок. Власники активів повинні визначити власні критерії прийнятності, сегментовані за рівнем ризику, щоб збалансувати потребу у швидкості з вимогою абсолютної цілісності даних.
| Метрика | Визначення | Критерій прийнятності (визначається власником) |
|---|---|---|
| Точність на рівні полів | Точний збіг вилученого значення з еталонними даними | Поріг для кожного поля; критичні помилки — окремо |
| Коректність документа | Усі обов'язкові поля в документі є правильними | Визначається на основі допустимого рівня ручної перевірки |
| Наскрізна автоматична обробка | Відсоток документів, оброблених без втручання людини | Оцінюється лише за умови підтвердженої коректності документів |
| Надійність процесу | Коректне авторизоване розміщення без втрат/дублікатів | Жодної втрати чи дубля в узгоджених тестових сценаріях |
Структурування пілотного впровадження
Щоб структурувати успішне впровадження, операційний директор повинен розпочати з контрольованого пілотного проекту. Команда має перевірити модель ШІ на розмічених зразках, категоризованих за постачальниками, шаблонами та типами документів. Вони також повинні використовувати контрольну вибірку документів — файли, які модель ніколи раніше не обробляла, — щоб протестувати реальну продуктивність на критичних полях.
Пілотний проект повинен підтвердити, що цільова ERP-система може прийняти структурований пакет даних через API. Якщо інтеграція не працює належним чином, вилучені дані залишаються ізольованими, а операційна цінність втрачається. Необхідно перевірити, як система обробляє відхилені транзакції та чи зберігається зв'язок між вихідним файлом і записом у реєстрі.
Остаточне рішення про масштабування базується на доведенні того, що налаштований робочий процес безпечно та надійно оновлює записи про технічне обслуговування та фінанси швидше, ніж ручне введення. Без підтвердження надійності наскрізного процесу автоматизація лише перемістить вузьке місце з етапу введення даних на етап виправлення помилок.
Контрольний список
- Перевірте модель розпізнавання на контрольній вибірці розмічених ремонтних документів за конкретними шаблонами постачальників.
- Визначте детерміновані правила зіставлення для критичних ідентифікаторів, таких як серійні номери активів та коди постачальників.
- Перевірте підтримку API та вимоги до прийняття даних для цільової ERP-системи або реєстру технічного обслуговування.
- Впровадьте перевірки на наявність дублікатів та ідемпотентність повторних спроб в автоматизованому робочому процесі розміщення.
- Виміряйте фактичний час, необхідний людині для виправлення помилок в інтерфейсі обробки винятків.
Запитання та відповіді
Чи вимагає впровадження ШІ-вилучення змін у нашій існуючій ERP-системі?
Це залежить від вашої поточної архітектури. Ви повинні перевірити, чи підтримує ваша ERP необхідні API для отримання структурованого пакета даних. Стандартних інтерфейсів не завжди достатньо, і може знадобитися робота з налаштування інтеграції для забезпечення надійного розміщення даних.
Як слід обробляти документи, де ШІ не може прочитати серійний номер?
Система повинна бути налаштована так, щоб позначати відсутні дані та направляти документ оператору. ШІ ніколи не повинен вигадувати або вгадувати невідомий серійний номер, оскільки це спотворює історію технічного обслуговування та розриває детермінований зв'язок із фізичним активом.